生成AIの業務活用が進む中、「RAG(検索拡張生成)」について知っておくことは大切です。
本記事では、RAGの基礎知識や仕組み、進化系であるAdvanced RAGなどの最新動向、導入メリットまでわかりやすく解説します。
ぜひ最後までご覧ください。
RAGとは、生成AIの回答精度を高めるために外部データを検索し、その情報を組み合わせて回答を生成する技術です。
従来の生成AIは、あらかじめ学習したデータのみをもとに回答を作成するため、最新情報や社内の独自情報には対応できませんでした。
しかし、RAGを活用することで、データベースや社内文書などの外部リソースをリアルタイムに参照し、正確な回答を出力できます。
AIモデル自体を更新せず、外部ナレッジを効率的に活用する手法として広く利用が進んでいます。
RAGは「ラグ」と読み、英語の「Retrieval-Augmented Generation」の頭文字を取った略称です。
日本語では「検索拡張生成」と訳されます。
これは、テキストを読み込んで回答を「生成(Generation)」するAIモデルに対し、関連情報を「検索(Retrieval)」して補強・「拡張(Augmented)」する技術を意味します。
つまり、AIが持つ既存の知識だけに頼るのではなく、外部の信頼できるデータベースから必要な情報を探して答えを作り出す仕組みのことを表しています。
大規模言語モデル(LLM)は優れた対話能力を持ちますが、「事実と異なる誤情報を生成する(ハルシネーション)」や「学習していない最新・社内情報に答えることができない」という大きな課題を抱えていました。
モデルを再学習・追加学習させるには多大なコストと時間がかかります。
RAGを導入すれば、モデルを再学習させることなく、常に最新データや社内の非公開ナレッジを参照させることが可能です。
コストを抑えつつLLMの実用性と信頼性を飛躍的に高められるため、ビジネス活用で重要な技術となっています。
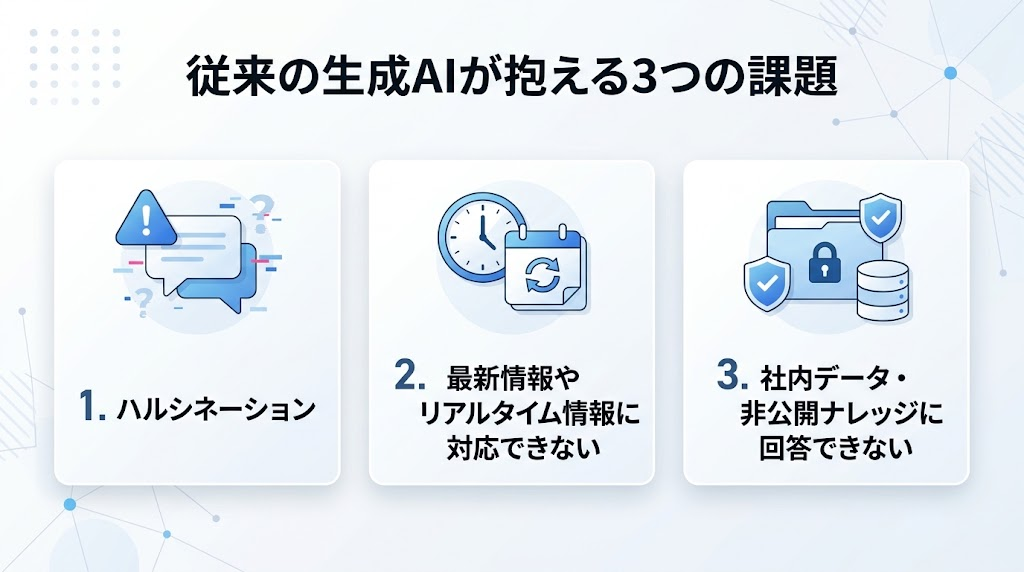
大規模言語モデルを活用した従来の生成AIは革新的な対話能力を持つ一方で、ビジネス実務に投入する上でいくつかの課題を抱えています。
文章の自然さや知識の広さに優れていても、回答の正確性や自社情報への適合という観点において単体では限界がありました。
RAGの導入意義を正しく理解するためにも、まずは従来のLLMが単体で直面していた代表的な制約とリスクについて詳しく確認していきましょう。
ハルシネーションとは、AIが事実とは異なる情報や嘘を「もっともらしく」生成してしまう現象のことです。
LLMは入力された文章に対して確率的に最も自然な単語の繋がりを予測・出力する仕組みのため、手元に正確な根拠がなくても知的なでっち上げを行ってしまうことがあります。
ビジネス現場で誤った情報を顧客や社員に提示すると信用問題に発展するリスクがあるため、生成AIの業務活用における致命的な障壁の一つとなっています。
従来のLLMは、過去の膨大な学習データに基づいて回答を生成します。
そのため、「知識のカットオフ」と呼ばれる学習データ更新の限界が存在し、最新のニュースやリアルタイムで変化する情報には回答できません。
例えば、昨日の出来事や最新の市場トレンド、直近で変更された法改正などの質問に対しては、情報が存在しないか古いデータを基に回答してしまいます。
変化の早いビジネス領域では、この点は大きなデメリットとなります。
汎用的なLLMはインターネット上の公開情報を中心に学習しているため、当然ながら各企業が独自に保有する社内マニュアルや顧客データ、業務手順書などの非公開ナレッジは把握していません。
そのため、「自社の経費精算ルール」や「自社製品のFAQ」といった社内固有の質問を投げかけても適切な回答を得ることは不可能です。
業務効率化のためにAIを活用したくても、そのままでは社内業務に応用できないという課題がありました。
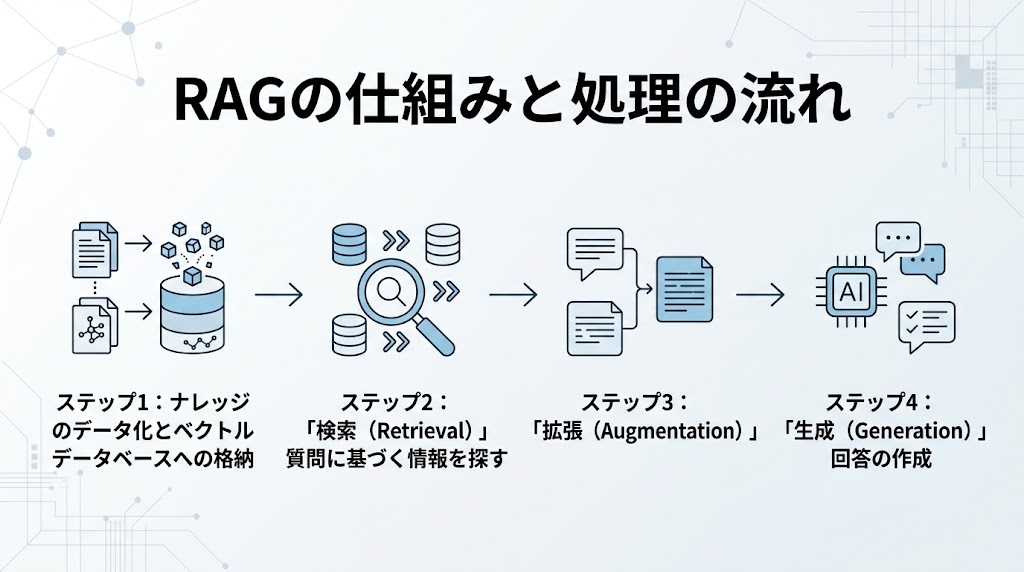
RAGは、単に質問へ回答するだけでなく、事前準備から情報の抽出、文章生成までの一連のプロセスをリアルタイムで連携させて機能します。
具体的な仕組みは「事前準備(ナレッジの格納)」「検索(Retrieval)」「生成(Generation)」という大きな3つの処理ステップに分けることができます。
このシステムフローを順番に理解することで、なぜRAGが正確でハルシネーションの少ない回答を出力できるのか、その構造が見えてきます。
最初のステップは、参照先となる社内文書やマニュアルなどのテキストデータをAIが検索しやすい形式に変換・保存する準備段階です。
文書は小さめの「チャンク(意味のまとまり)」に分割され、数値を意味空間上に配置する「ベクトル化(埋め込み)」処理が行われます。
この処理によって意味や文脈の近さを計算できる形式になり、専用の「ベクトルデータベース(Vector DB)」に格納されます。
この事前準備により、超高速かつ正確な意味検索が可能になります。
ユーザーがチャットボットなどに質問を入力すると、システムは入力された質問文も即座にベクトルデータへ変換します。
次に、ベクトルデータベース内を照合し、質問の数値データと類似度の高い(意味が近い)データの上位セグメントを瞬時に検索・抽出(Retrieval)します。
単なるキーワードの一致判定ではなく、文脈や意図の類似性を基に最も関連性の高い情報(回答の根拠データ)を特定・厳選する点が、従来の検索システムとの違いです。
抽出された関連データは、ユーザーの元の質問文と組み合わされ、LLMへの指示文へと統合・拡張(Augmentation)されます。
この際、「以下の参照データに基づいて回答を作成してください」といった背景情報が付加されます。
AIが持つ既存の知識のみに頼るのではなく、検索によって得た信頼性の高い最新情報をプロンプト上に提示して文脈を強化(拡張)することでLLMが学習していない情報についても回答できるようになります。
最後のステップでは、抽出された関連データとユーザーの質問文、さらに「提示した情報のみに基づいて正確に回答してください」という指示(プロンプト)をセットにしてLLMへ送信します。
LLMは与えられたデータを参照しながら自然な文章へと集約・加工し、回答を「生成(Generation)」してユーザーへ提示します。
この3つのステップを経ることで、事実に基づいた信頼性の高い応答が実現します。
生成AIの回答精度や業務適用度を高める手法には、RAGのほかに「ファインチューニング」や「プロンプトエンジニアリング」が存在します。
これらはアプローチの仕組みやコスト、適したユースケースが大きく異なります。
ファインチューニングとは、既存のAIモデルに特定の追加データを再学習させ、モデル自体の重み(パラメータ)を調整・最適化する手法です。
モデルのトーン&マナーや業界専門用語の応答スタイルを学習させるのに適していますが、追加学習には高額な計算コストと専門知識が必要です。
また、情報が更新されるたびに再学習を行う手間が発生します。
一方、RAGはモデルを更新せず外部データを参照するため、即座に最新情報を反映でき、コスト面でも非常に優れています。
プロンプトエンジニアリングとは、AIモデルへの指示文の書き方を工夫することで、望ましい回答を引き出す手法です。
開発コストやシステム追加が不要で即座に試せる手軽さがある反面、モデルが入力として受け取れる文字数(コンテキストウィンドウ)に制限があるため、大量の社内文書やマニュアルを直接読み込ませるには限界があります。
RAGは自動で関連文書を検索してプロンプトへ注入するため、膨大なナレッジを扱える点が大きな違いです。
各手法の違いを比較表でまとめました。
ここでは、企業がRAGをシステムやサービスに導入することで得られる主要なメリットについて、ビジネス現場の視点からわかりやすく解説します。
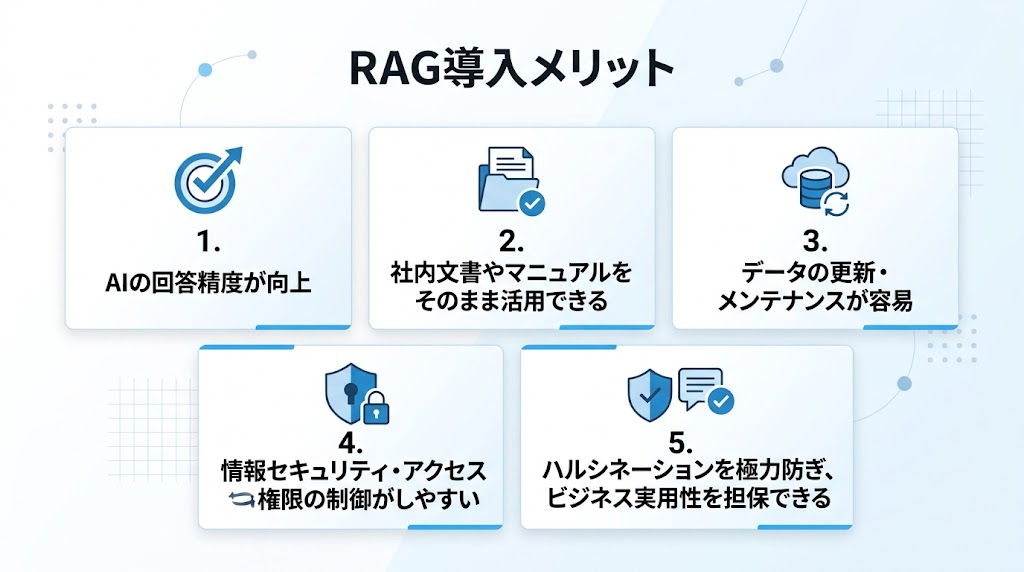
RAGのメリットは、回答の根拠となる参照元データ(情報ソース)を明示できる点です。
AIが生成したテキストとともに「どの文書のどのページを参照したか」を出力できるため、ユーザーは提示された根拠情報を即座にファクトチェック(事実確認)できます。
これによって、従来の生成AIにありがちだった「回答のどこまでが正しくて真実なのかわからない」という不安が解消しやすくなり、出力結果の信頼性が高まります。
RAGは、自社がすでに保有しているPDFマニュアル、FAQデータ、過去の対応履歴などのテキストファイルをそのままデータベースへ読み込ませて活用できます。
既存の社内ナレッジをAI用に特殊な形式へ大規模加工したり、モデルへ再学習させたりする膨大な手作業は必要ありません。
社内に眠っている大量の規程集やノウハウ資産をそのまま「AIの参照用ナレッジ」として即座に有効活用できるため、業務の属人化解消に大きく貢献します。
ファインチューニングなどの手法では、情報が更新されるたびに高額なインフラ費用と時間をかけてモデルを再学習させる必要がありました。
一方、RAGであれば、参照元となるデータベース内の文書ファイルを差し替える・更新するだけで、即座に最新の回答を生成できるようになります。
制度変更や新商品の追加、マニュアル改訂などが頻繁に発生するビジネス現場においても、低コストかつ迅速にナレッジの運用メンテナンスが行える点が大きな利点です。
企業でAIを利用する際、役職や部署に応じた「情報の閲覧権限(アクセス制御)」の管理は不可欠です。
RAGではデータベース側でユーザーの権限(グループ権限やアクセス制限)に応じた検索フィルタリングを設定できます。
「人事部以外の社員には給与規程を参照させない」といった権限管理を柔軟に行えます。
機密情報や個人情報の漏洩リスクを最小限に抑えながら、安全なガバナンス下で生成AIを業務に運用できます。
生成AIのビジネス利用において最大の壁となるのが「ハルシネーション(嘘の生成)」リスクです。
RAGでは「提示した検索データのみに基づいて回答を作成する」という制限をプロンプトで厳格に指示するため、事実無根のでっち上げ回答を強力に抑止します。
根拠がない質問に対しては「該当する情報が見つかりませんでした」と返答させることが可能なため、誤情報の展開が許されないカスタマーサポートや業務ヘルプデスクでも安心して実用化できます。
実用面においては、RAG搭載のAIツールを導入・利用する際に、回答には社内で登録した文書やナレッジのみを参照するような設定をするのがハルシネーションを防ぐ上で安心と言えます。
RAGは生成AIの利便性と正確性を大幅に高める素晴らしい技術ですが、導入や運用において万能というわけではありません。
ここでは、RAGの導入時に配慮すべき主要なデメリットと課題について詳しくみていきましょう。
RAGの回答品質は、参照先となる外部データベースのデータ品質や検索アルゴリズムの性能に大きく依存します。
「Garbage In, Garbage Out(ゴミを入れればゴミが出る)」の原則通り、元となるマニュアルやナレッジデータに誤りや古い情報、不適切なデータ分割があると、AIは誤った回答を出力してしまいます。
また、ユーザーの質問意図に合致した情報を的確に探して引き出す高度なベクトル検索技術やリランキング処理のチューニングが不可欠となります。
RAGは、ユーザーの質問入力から回答完了までに「質問文のベクトル化」「データベースからの関連検索」「検索結果を組み込んだプロンプトの作成」「LLMによる文章生成」という複数の処理ステップを順次実行します。
そのため、シンプルな生成AIとの一括やり取りに比べて処理フローが長くなり、回答が出力されるまでにタイムラグ(レイテンシ)が生じるリスクがあります。
応答速度が遅いとユーザー体験(UX)や業務効率を損ねるため、システム側の設計工夫が必要です。
RAGの導入・継続運用には、一定の開発・保守コストがかかります。
社内データを管理・検索するためのベクトルデータベース(Vector DB)や検索インフラの維持費用に加え、LLMや検索APIの利用量に応じた従量課金コストが発生します。
また、社内データの更新管理や検索精度の改善作業など、継続的な運用リソース(人件費や管理工数)も考慮しなければなりません。
導入前には想定される利用規模に応じた全体コストと費用対効果の事前シミュレーションが極めて重要です。

ここでは、RAGの導入によって大きく成果を上げやすい主な活用シーンについて紹介します。
自社での導入検討や具体的なユースケースのイメージ作成にお役立てください。
情報システム部や総務・労務といった社内バックオフィスには、社員から日々「PCの設定方法」や「経費精算の手続き」「有給休暇の申請ルール」などの問い合わせが殺到します。
RAGを導入することで、社内規定やFAQデータをリアルタイムに参照するAIチャットボットとして活用できます。
社員は知りたい情報を即座に自己解決できるようになり、バックオフィス担当者は問い合わせ対応の工数を大幅に削減してコア業務へ集中できます。
RAGは社内用途にとどまらず、外部顧客向けのカスタマーサポートやWeb接客の領域でも効果を発揮します。
従来型のFAQチャットボットは、あらかじめ設定した固定の回答分岐しか対応できず、顧客の複雑な問い合わせに答えられないケースが多くありました。
RAGを活用することで、Webサイト上の最新の商品マニュアルや規約データを直接参照し、顧客一人ひとりの自然な対話に対して正確な回答を即座に生成できます。
24時間365日の高精度な自動応答が可能となり、顧客体験の向上と問い合わせ対応コストの削減を同時に実現します。
技術資料、製品スペック表、過去の提案書など、膨大なマニュアルやナレッジを抱える現場では、必要な情報に辿り着くまでに多大な時間がかかります。
RAGを業務ナレッジ検索基盤として活用すれば、ユーザーが「〇〇製品のトラブル対応手順は?」と質問するだけで、AIが膨大なファイル群から該当箇所を探し出し、要約した回答と参照元ドキュメントを即座に提示します。
熟練社員の頭の中にあったノウハウの属人化を防ぎ、組織全体の検索コスト削減に貢献します。
生成AIの技術革新に伴い、初期に構築されたシンプルなRAGシステム(Naive RAG)から、より複雑なビジネス課題に対応する次世代RAGへの進化が進んでいます。
ここでは、最先端の検索拡張生成として注目を集める「Advanced RAG」「GraphRAG」「Agentic RAG」のトレンドについて紹介します。
文章を単純分割してキーワード照合する初期の「Naive RAG」では、必要なコンテキストの欠落や、無関係なノイズ情報の取得による精度低下が大きな課題でした。
この限界を補う手法として登場したのが「Advanced RAG」です。
テキストデータの適切な意味単位での切り出し(チャンク最適化)や、キーワード検索とベクトル検索を組み合わせる「ハイブリッド検索」、さらに抽出結果をLLMへ渡す前に重要度順に再並び替えを行う「リランキング(Reranking)」等の精度向上技術が標準化されています。
文章単位の類似度検索だけでは捉えきれない情報の構成要素同士の複雑な関係性や全社的文脈を解釈するため、ナレッジグラフを活用する「GraphRAG」が注目されています。
情報を点ではなく網の目のネットワークとして保持することで、組織全体の構造や複数文書にまたがる広域な質問に対しても正確な推論が可能です。
最新のRAGトレンドにおいて非常に革新的な進化が「Agentic RAG(エージェント型RAG)」です。
これは、単一の検索・生成プロセスを自動実行するのではなく、AIエージェントが自ら回答プランを策定し、必要に応じて「検索クエリの自動再構築」「複数の外部データソースへの段階的アクセス」「回答内容の検証・修正」を自律的かつループ状に行う仕組みです。
複雑なビジネス判断や多段階のロジックを要する高度なタスクにおいても、極めて高精度な回答を出力できます。
RAGの導入で成果を出すには、単に技術やツールを導入するだけでなく、事前の目的設定からデータ整備、導入後の継続改善までを見通した戦略的アプローチが不可欠です。
ここでは、RAGの導入を成功に導くための主要な「3つの手順とポイント」について詳しく解説します。
導入にあたって最初に取り組むべきは、AIにどの業務(社内FAQ、カスタマーサポートなど)を担当させるかの目的明確化と、参照させるナレッジの整理です。
社内に散在する規程集やマニュアルから重複データや古い情報を精査・排除し、最新かつ正確なデータのみをAIの参照先として統合・整理します。
事前処理としてデータの構造化や不要な装飾の削除などを行うことで、RAGの検索精度を飛躍的に向上させる重要な第一歩となります。
自社でゼロからRAGを開発・運用するには、高度な技術ノウハウとインフラ構築コストが求められます。
そのため、実用性とスピードを重視する場合は、外部サービス連携機能や便利な機能が備わったパッケージ型AIサービスの活用がおすすめです。
「自社データ(Google DriveやSharePoint等)との同期の手軽さ」「セキュリティ設計(アクセス制御)」「導入の手軽さ」を兼ね備えたツールを選ぶことが特に大切です。
RAGは運用を開始して終わりではなく、継続的な精度評価とフィードバックループの構築が大切です。
ユーザーからの回答評価や問い合わせ履歴を適切に分析し、AIが誤答した原因(参照データの不足や不適切な抽出)を特定・修正する改善プロセスを回し続けることが重要です。
ナレッジの追加やQ&Aの自動アップデート提案機能などを活かし、常にAIの回答品質を最適化していく必要があります。
💡 社内ナレッジの活用やRAG導入にお悩みなら
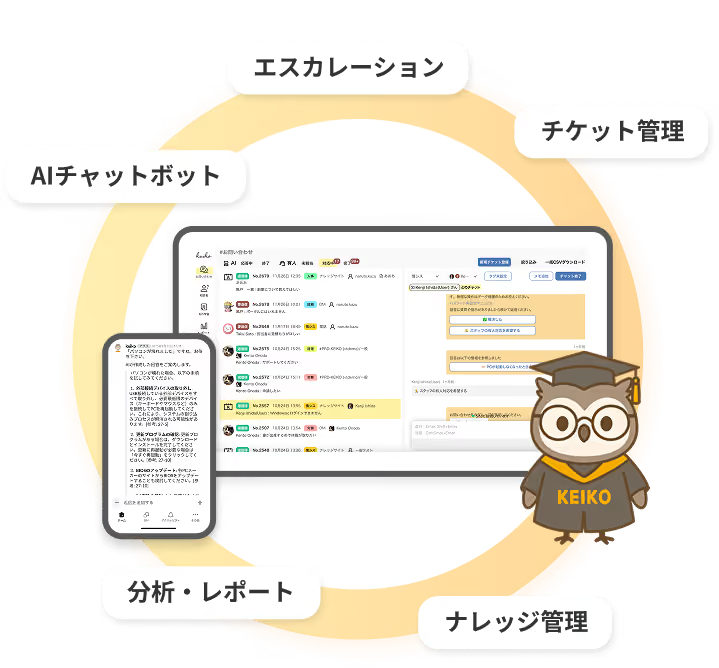
次世代AIサービス「helpmeee! KEIKO」なら、自社の各種資料やQ&Aデータを登録するだけで、高精度なRAG搭載AIチャットボットが自動回答を実現します。
バックオフィスの問い合わせ対応工数を大幅に削減し、社内ナレッジをスムーズに資産化可能です。
RAGは、従来の生成AIが持つ「最新情報や社内データに対応できない」という弱点を克服し、回答の精度と信頼性を飛躍的に高める技術です。
自社の導入目的に合った適切なRAGツールやAIサービスを選定し、生成AIのビジネス活用と組織全体の生産性向上を推進していきましょう。